AI 推薦品牌偏好大品牌嗎?1,176 個品牌的 GEO 研究
TL;DR
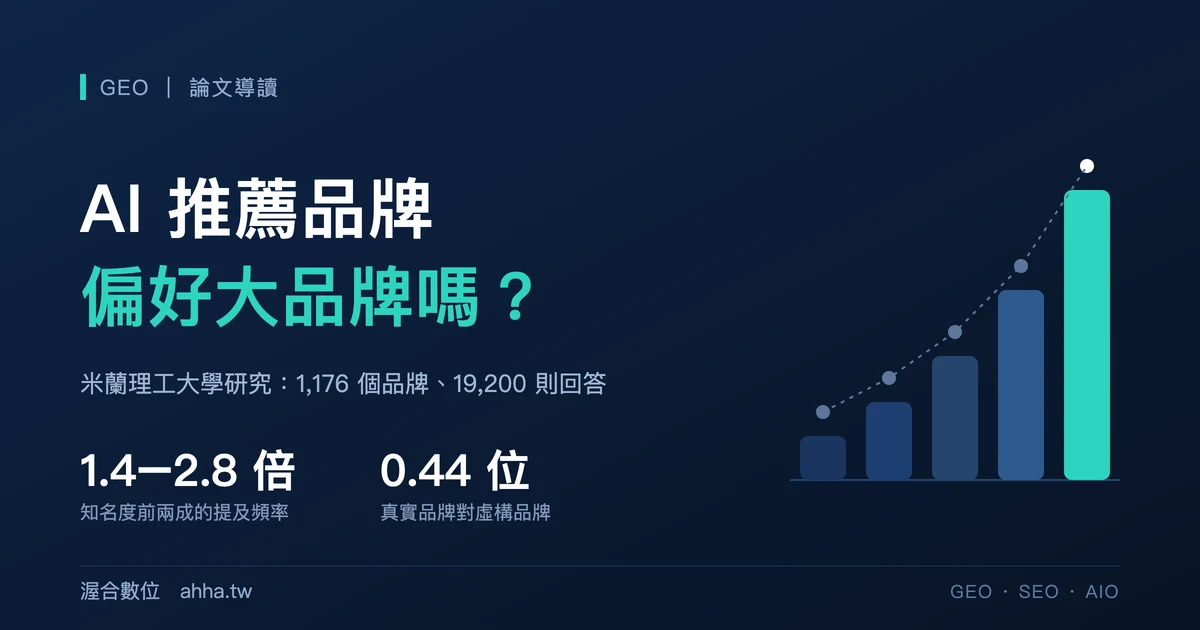
- 米蘭理工大學的研究以 80 道不含品牌名的商業問句,向三個 AI 引擎取得 19,200 則回答、整理出 1,176 個品牌:知名度排在前兩成的品牌,被提及與引用的頻率是同引擎、同產業平均的 1.4 至 2.8 倍。
- 開啟網路搜尋並沒有縮小這個差距。關閉與開啟搜尋時,知名度對提及率的影響幾乎相同,兩者之間沒有統計上的顯著差異。
- 對照實驗把同一份產品頁的署名換掉:由真實品牌換成虛構品牌,在五個頁面中的平均排名下降 0.44 位;知名度較高與較低的真實品牌之間,則沒有顯著差異。
- 不更動事實的內容改寫(調整結構、流暢度、權威語氣)平均只移動 0.02 位,未達顯著。這項實驗是在關閉搜尋的條件下進行,不能推論為內容優化一律無效。
- 問句帶上使用者情境後,大品牌的優勢會下降;經查核的品牌提及中,有 36.2% 的品牌名稱只出現在第三方頁面。
目錄
- 品牌偏差研究的設計:兩項實驗
- 品牌知名度與 AI 提及率的關係
- 開啟網路搜尋對品牌偏差的影響
- 模型認得的品牌與虛構品牌的排名差距
- 內容改寫對 AI 推薦排名的效果
- 使用者情境對大品牌優勢的影響
- 與台灣 AI 推薦實測的對照
- 研究限制與判讀範圍
- 對品牌經營與 GEO 的意義
- 參考來源
引言
向 AI 詢問「哪一家機車險比較好」這類問題時,回答裡通常只會出現少數幾個品牌。這幾個名額是怎麼分配的,過去多半只能憑印象推測:有人認為 AI 會上網查資料,所以內容寫得好的小品牌有機會;也有人認為 AI 只會重複它本來就知道的大品牌。
米蘭理工大學(Politecnico di Milano)的三位研究者在 2026 年 11 月發表的論文〈The Popular Get More Popular: Auditing Brand Bias in Generative Search〉,把這個問題拆成兩個可以量測的部分。第一部分是觀察:品牌的知名度與它被 AI 提及的頻率之間有多大的關聯,開啟網路搜尋之後這個關聯會不會變弱。第二部分是對照實驗:把同一份產品頁的品牌名稱換掉、或者把內容改寫,看排名會移動多少。
論文摘要的說法相當強烈,稱生成式搜尋會強化既有的市場領導者,而且這道門檻無法靠內容優化跨過。細讀正文之後,數據支持的範圍比摘要窄,其中有兩處對 GEO(生成式引擎最佳化)的實務判斷影響很大,本篇會分別說明。
品牌偏差研究的設計:兩項實驗
核心觀點: 實驗一量的是知名度與被提及頻率的關聯,實驗二則是能夠區分原因的對照實驗,兩者回答的問題不同。
實驗一是一次稽核。研究者從關鍵字資料庫取得義大利市場四個產業(保險、旅遊、時尚美妝、運動)的商業關鍵字,只保留不含任何品牌名稱的關鍵字,再把每個關鍵字改寫成一句義大利文的提問,每個產業 20 道,共 80 道。每一道問句分別以「不帶使用者情境」與三種使用者情境提出,並且在關閉搜尋與開啟搜尋兩種條件下,各向 GPT、Gemini、Perplexity 三個引擎詢問 10 次,合計 19,200 則回答,全部在 2026 年 10 月 14 日取得。
品牌的納入標準是在某個產業中被至少一個引擎提及 5 次以上,符合的有 1,176 個。知名度的量法是該品牌名稱在義大利的 Google 月平均搜尋量。研究者區分了兩個指標:「提及」指品牌名稱出現在回答的文字裡,「引用」指品牌的官方網站出現在回答所附的來源中;後者只計算查得到官方網域的 683 個品牌。
實驗二則是對照實驗。研究者從實驗一挑出 24 道問句,每次提供五個產品頁給模型,要求模型回答問題並為五個頁面排序。五個頁面當中有一個是目標頁,研究者只改動它的兩樣東西:署名的品牌,以及文字的寫法,其餘完全相同。這項實驗由四個模型在關閉搜尋的條件下進行,共取得 48,000 次排序。由於頁面內容固定、只有名稱或寫法不同,排名的差異才能歸因到被改動的那一項。
品牌知名度與 AI 提及率的關係
核心觀點: 知名度前兩成的品牌,被提及與引用的頻率是平均的 1.4 至 2.8 倍;這個數字描述的是「已經被 AI 提到的品牌」之間的差距。
研究者把品牌依知名度分成五等分。知名度最低的一組,平均每個品牌出現在不到 1% 的回答裡;知名度最高的一組則是 1.2% 至 5.3%,依引擎而異。知名度與提及率之間的正相關,在 24 種「引擎 × 產業 × 搜尋開關」的組合中有 23 種達到統計顯著。換算成相對值,知名度最高那一組的品牌,被提及與引用的頻率是同引擎、同產業平均值的 1.4 至 2.8 倍。
官方網站被引用的情況比較不一致。知名度與引用率的關聯,在 12 組「引擎 × 產業」當中有 8 組顯著,研究者自己的判定是「部分支持」。
1,176 個品牌都是至少被提及 5 次的品牌,從未被任何引擎提到的品牌並不在分析之內。1.4 至 2.8 倍這個差距,是在已經進入 AI 回答的品牌之間量出來的,真正的長尾品牌面對的落差,這份資料沒有量到。
開啟網路搜尋對品牌偏差的影響
核心觀點: 開啟搜尋沒有讓知名度的影響變小,原因之一是模型會把自己記得的品牌直接寫進搜尋字串。
研究者原本的假設是:關閉搜尋時,模型只能依靠訓練時記下的知識,偏差應該比較嚴重;開啟搜尋之後有了外部資料,偏差應該減輕。結果這項假設沒有得到支持。品牌的 Google 搜尋量每高出 10 倍,在關閉搜尋時每 100 則回答會多被提及 0.87 則,開啟搜尋時是 0.89 則,兩者的差距(0.02)在統計上無法與零區分。
搜尋紀錄可以解釋一部分原因。GPT 在回答之前會自己擬定搜尋字串,而這些字串當中有一部分已經帶著品牌名稱。以旅遊產業為例,被提及的品牌之中,名稱在第一次搜尋就已經出現在搜尋字串裡的比例,知名度最低的一組是 7%,知名度最高的一組是 45%;保險產業的幅度較小,由 1% 上升到 8%,同樣達到顯著。模型在搜尋之前就已經想到某些品牌,搜尋的作用因此比較接近替既有的答案找佐證,候選名單有一部分在搜尋之前就已經形成。
研究者另外查核了 30,006 次品牌提及,其中 36.2% 的品牌名稱只出現在第三方頁面,品牌自己的官網並不在回答所附的來源裡(GPT 為 29.1%,Gemini 42.9%,Perplexity 42.6%)。品牌可以出現在回答裡,卻沒有被引用。
論文所說的「開啟搜尋」是指允許引擎搜尋,引擎不一定真的執行:三個引擎實際進行搜尋的比例分別是 GPT 98%、Perplexity 100%,Gemini 則只有 44%。Gemini 在開啟搜尋條件下的回答,有一半以上實際上沒有執行搜尋。
模型認得的品牌與虛構品牌的排名差距
核心觀點: 內容完全相同時,真實品牌比虛構品牌平均高出 0.44 位;知名度高與低的真實品牌之間,差距則不顯著。
實驗一只能說明知名度與提及率有關聯,無法排除「大品牌的產品確實比較好」這類解釋。實驗二的設計就是為了處理這一點:同一份產品頁文字,只更換署名。
以原本的品牌署名時,目標頁在五個頁面中的平均排名是 3.21;換成虛構的品牌名稱之後是 3.65,相差 0.44 位,四個模型、四個產業的方向都一致。產品名稱也有影響,但幅度較小:保留真實品牌、只把產品名稱換成虛構的,排名下降 0.14 位。
論文摘要沒有強調、但對實務判斷最重要的一組結果,出現在「換成別的真實品牌」這個條件。研究者讓同一份頁面分別由同類別中知名度較高與較低的另外兩個真實品牌署名,兩者之間的排名差距只有 0.05 位,未達顯著。另一方面,知名度較低的真實品牌,排名仍然比虛構品牌高出 0.19 位,這個差距是顯著的。
把這幾個數字放在一起,對照實驗量到的分界並不是大品牌與小品牌,而是模型認得的品牌與模型不認得的品牌。研究者把後者稱為「熟悉度偏差」,並推論它來自模型的參數記憶(模型在訓練階段記下、不必上網查詢就具備的知識)。實驗一觀察到的「知名度愈高、愈常被提及」仍然成立,但那是相關性;到了控制內容的實驗裡,知名度高低本身並沒有再造成可辨識的排名差異。
內容改寫對 AI 推薦排名的效果
核心觀點: 三種不更動事實的改寫平均只移動 0.02 位;這個結果的適用範圍,限於關閉搜尋、且不新增任何事實的改寫。
實驗二同時測試了內容的寫法。研究者準備了三種改寫:把決策所需的資訊移到最前面並加上標題與條列的「結構」版本、「流暢」版本,以及語氣更篤定的「權威」版本。三種改寫都不得新增或刪除事實,數字必須與原文一致,長度也限制在原文的正負 15% 以內,以免排名的變化其實來自篇幅。
三種改寫各自移動的幅度都在 0.02 位上下,平均是 0.022 位,未達顯著,而且信賴區間(估計值可能落入的範圍)排除了大於 0.05 位的效果。與更換品牌名稱相比,品牌名稱的影響比改寫高出 0.42 位。
這個結果很容易被簡化成「內容優化沒有用」,但實驗條件並不支持這麼廣的說法。第一,排序是在關閉搜尋的條件下進行,五個頁面已經擺在模型面前,改寫能不能讓頁面更容易被檢索到,並不在測試範圍內。第二,改寫被限制為不更動事實,研究者明確排除了新增內容的做法,因此補上原本缺少的規格、價格或實測資料會有什麼效果,這項實驗沒有回答。
我們先前導讀過南加大團隊關於改寫與 AI 引用的實驗,該研究發現把文章改寫得更有說服力在部分情況下有效,但效果極不穩定。兩份研究的條件不同,不宜直接比較高下;比較穩妥的讀法是,只調整呈現方式而沒有增加實質內容的改寫,效果小而且不可靠。
使用者情境對大品牌優勢的影響
核心觀點: 問句帶上預算與身分等情境之後,知名度對提及率的影響下降約兩成,搜尋字串也隨之改變。
實驗一的提問有四分之三附帶了使用者情境。研究者為每個產業寫了三種情境,各用三句話描述提問者的人生階段、對該類產品的經驗與價格態度,例如希望盡量少花錢。
不帶情境時,品牌的 Google 搜尋量每高出 10 倍,每 100 則回答會多被提及 0.98 則;帶上基準情境之後降到 0.80 則,價格情境是 0.85 則,兩者都顯著低於不帶情境的結果。第三種只更動人生階段或經驗的情境為 0.89 則,未達顯著。
情境同時改變了引擎的搜尋行為。在時尚美妝、運動與旅遊三個產業,帶有基準情境或第三種情境的提問,有 86% 至 96% 會在搜尋字串裡出現價格相關的字詞,不帶情境時只有 25% 至 46%。提問者交代了條件,引擎就會依條件調整搜尋的內容,回答也較少集中在它最熟悉的品牌。
與台灣 AI 推薦實測的對照
核心觀點: 論文的兩項觀察,在我們以台灣在地問句進行的實測中有方向一致的結果,但量測方式不同,數字不能直接比較。
論文的資料來自義大利市場與 API(由程式直接呼叫模型的管道)。我們過去三期的實測使用繁體中文問句,並且透過未登入的一般網頁介面取樣,兩者在語言、市場、介面與規模上都不相同。以下兩點只能說明方向是否一致。
第一點是具體需求的影響。我們在問句措辭的實測中,把「台南 牙醫 推薦」這類問句加上一項具體需求(例如「洗牙不會太痛的」),ChatGPT 的推薦名單與原問句的重疊率由重問同一句的 24.3% 降到 6.8%。這與論文中「帶上情境後大品牌優勢下降」的觀察方向相同:提問愈具體,名單愈不會停留在原本那一批。
第二點是第三方頁面的角色。我們在在地店家引用來源的實測中統計過,AI 推薦在地店家時所附的來源,業者官網約占三分之一,目錄與平台類約占三成。論文的 36.2% 量的是另一件事(品牌名稱只在第三方頁面找得到的提及比例),但兩份資料都指出,品牌出現在 AI 回答裡,有相當比例不是經由自己的官網。
品牌名稱本身會影響排序這一點,多倫多大學的研究也以不同的設計得到類似結果:在產品事實完全相同的條件下,揭露品牌名稱會改變產品進入前三名的比例。該研究的導讀見〈FAQ、Schema 能提高 AI 引用嗎?〉。兩個研究團隊、兩個市場得到同方向的結果,比單一研究更值得參考。
研究限制與判讀範圍
核心觀點: 這份研究的資料來自單一市場、單一日期與 API,對照實驗的效果量也不大,引用時應保留這些條件。
論文作者自己列出的限制,加上細讀後需要補充的部分,整理如下:
- 單一市場與時間點。 所有提問都是義大利文、定位在羅馬,實驗一的資料在同一天取得。其他語言與市場是否有相同結果,論文沒有驗證,中文更不在範圍內。
- 透過 API 取得。 作者說明 API 可能不包含一般使用者介面所帶的系統設定,結果與實際使用者看到的回答之間可能有落差。
- 對照實驗在關閉搜尋下進行。 實驗二呈現的是模型拿到頁面之後如何排序,不包含檢索與重新排序的過程。
- 樣本只含已被提及的品牌。 從未被 AI 提到的品牌不在 1,176 個之內。
- 效果量不大。 0.44 位是在一到五名的尺度上量到的平均差距,足以說明偏差存在,但不代表虛構品牌一律排在最後。
- 知名度是代理指標。 論文以 Google 搜尋量代表知名度,這與模型實際「記得多少」並不是同一件事。
- 部分結論屬於推測。 作者在討論中提到長尾品牌可能面臨接近完全消失的風險,也提到新創品牌可能處於劣勢,但論文並沒有測試在模型訓練截止之後才成立的品牌,作者將其列為後續研究。
對品牌經營與 GEO 的意義
核心觀點: 對照實驗指出的門檻是「被模型認得」,與品牌規模大小的關係有限;能夠影響推薦結果的工作,有一大部分發生在官網之外。
這份研究最容易被誤讀的地方,是把它當成「小品牌沒有機會」的證據。對照實驗的結果其實比較接近相反的方向:知名度較低的真實品牌與知名度較高的真實品牌之間沒有顯著差距,處於劣勢的是模型完全不認得的名稱。對多數已經經營一段時間的品牌而言,需要先確認的是自己落在分界的哪一邊。
模型是否認得一個品牌,取決於訓練資料裡有沒有足夠的內容提到它。論文沒有測試如何讓品牌被模型記住,以下三點是我們依據論文數據所做的推論,論文本身並未提出這些建議。首先,36.2% 的提及只在第三方頁面找得到,表示產業媒體、評測文章、目錄與平台上的品牌資訊,是品牌進入 AI 回答的實際通道之一,這些地方的品牌名稱與基本資料應該保持一致。其次,帶有具體條件的提問會降低大品牌的優勢,因此針對特定情境、特定需求撰寫的內容,比泛談品牌優點的內容更有機會被找到。最後,只調整文字呈現方式的改寫效果有限,資源應該放在增加可查證的實質內容上。
要判斷品牌目前的位置,可以先做一個粗略的檢查:以不含品牌名稱的行業問句向幾個 AI 助理提問,重複數次,記錄品牌是否出現;再直接詢問該品牌是什麼,觀察回答的內容是否正確。前者反映品牌在推薦情境中的能見度,後者大致反映模型對品牌的認識程度。AI 的回答具有隨機性,單次結果不足以下判斷,這一點在名單穩定度的實測中已經說明過。
關於 AI 推薦與 GEO 的實測與研究導讀,我們會持續在 GEO 研究所社團分享。
參考來源
- Monaco, G., Lenti, J., & Pierri, F. (2026). The Popular Get More Popular: Auditing Brand Bias in Generative Search. arXiv:2611.07614.
- Chen, M., & Koudas, N. (2026). What Drives AI Citations? Content, Retrieval and Model Knowledge in Generative Engine Optimization (GEO). arXiv:2610.15033.
- AI 推薦在地店家時,引用的是誰的內容?175 筆回答的分類實測
- AI 推薦的店家會因問法改變嗎?144 筆實測,同句重問也只重疊兩成
常見問題
AI 推薦品牌時真的偏好大品牌嗎?
在米蘭理工大學的研究中,知名度排在前兩成的品牌,被 AI 提及與引用的頻率是同引擎、同產業平均的 1.4 至 2.8 倍。不過在控制內容的對照實驗裡,知名度較高與較低的真實品牌之間沒有顯著的排名差距,差距出現在真實品牌與模型不認得的虛構品牌之間。
AI 開啟網路搜尋之後,小品牌會比較有機會嗎?
這份研究沒有觀察到這個效果。品牌的 Google 搜尋量每高出 10 倍,關閉搜尋時每 100 則回答多被提及 0.87 則,開啟搜尋時為 0.89 則,兩者沒有顯著差異。論文指出,模型會把自己記得的品牌直接寫進搜尋字串。
改寫文章內容可以提高被 AI 推薦的排名嗎?
研究測試了三種不更動事實的改寫(結構、流暢度、權威語氣),平均只移動 0.02 位,未達顯著。這項實驗是在關閉搜尋、且不得新增事實的條件下進行,因此不能推論為補充實質內容或改善可檢索性也沒有效果。
這份研究的結果適用於台灣嗎?
研究的問句是義大利文、定位在羅馬,資料透過 API 在單一日期取得,沒有涵蓋中文或台灣市場。我們以繁體中文在地問句進行的實測中,有兩項觀察與論文方向一致,但量測方式不同,數字不能直接比較。
不想一個個手動設 SEO / GEO?
AHHA 自助架站平台內建 Schema.org、llms.txt、hreflang、FAQPage 的自動輸出,建站當天就具備被 Google 與 AI 系統讀取的技術基礎。
- Schema.org / llms.txt / hreflang 自動輸出,不需撰寫程式
- FAQPage、Article、LocalBusiness 等結構化資料自動產生
- 內建 SEO + GEO + AI SEO 健檢,可即時檢測
- 14 天免費試用,不需信用卡
SEO/GEO/AIO 優化 分類其他文章
繼續閱讀同主題的延伸內容
留言討論
只有會員能留言(防止垃圾訊息),留言顯示於此頁。